让 Agent 感知搜索何时收敛
开题、综述与研究方案论证,往往需要持续检索和多次核验。研究者既要判断材料是否充分,也要整理重复论文、追踪来源,并在研究方向调整后重新检查已有结论。这些工作会占用原本可以用于方法比较和学术判断的时间。
LightRead 将资料检索、阅读、证据整理与后续分析组织在同一项研究任务中。研究者给出问题、资料范围和交付要求,Agent 持续处理相应工作,并将材料与结果保存在工作区。减少重复筛选、保留核验依据、让已有成果支持下一阶段,是这套检索设计服务于研究者的具体方式。
跨数据库检索往往需要反复调整关键词、筛选条件与引文追踪路径。随着研究推进,多个查询可能持续命中同一批论文。此时,结果列表的长度已经不足以说明检索进展:一次返回数十条记录的查询,可能没有增加任何新的相关资料。
Agent 需要能够区分重复返回与有效增量,才能判断是否继续沿当前路径检索。长程任务还存在另一项约束:上下文压缩会移除部分已经展开的材料。如果去重状态没有随之更新,曾经检索到的证据可能同时退出模型上下文和后续搜索结果,影响模型对资料充分性的判断。
LightRead 的检索设计将结果去重、上下文可见性与证据恢复结合起来。去重减少重复材料的处理开销,恢复机制保留重新核验原始证据的条件;在此基础上,新增资料的变化才有助于判断当前检索范围是否趋于收敛。
依据上下文可见性维护去重状态
设第一轮检索返回三篇论文,其标题与摘要均已展开在上下文中。第二轮调整关键词后,结果包含原有三篇论文和一篇新论文。只要原有材料仍然可见,就可以抑制重复展开,将新增论文交给模型处理。
经过这样的处理,工具命中数量与模型获得的新增资料数量便可以区分。一次查询即使命中较多条目,也可能仅提供少量增量。Agent 可以据此评估当前路径的收益,并决定是否扩展查询条件或转向其他来源。
重复识别可依据平台标识、DOI、标题和网页链接,并结合相应来源的标识规则。同一篇论文在不同数据库中的记录需要归并;主题相近但实际不同的研究,仍应作为独立资料保留。
多 Agent 协作进一步要求区分资料身份与各 Agent 实际可见的证据。子 Agent 已阅读的论文,未必已经传入主 Agent 的上下文;分别承担方法分析与实验核验的子 Agent,也可能需要独立读取同一份原文。因此,汇总阶段的文献去重,不应阻断各执行者获取必要证据的路径。
上下文压缩后的证据恢复
随着任务延长,早期论文的详细摘要可能被压缩为少量研究进展。若后续需要比较实验结果,模型仍须重新核对原文中的数据集、评测条件或指标定义。阶段摘要未必保留这些细节。
如果系统继续沿用压缩前的去重状态,将相关论文持续排除在后续结果之外,模型就可能把暂时不可见的证据误判为不存在。该问题直接影响检索收敛判断:结果减少既可能来自重复过滤,也可能来自证据恢复路径受到限制。
因此,LightRead 的检索设计要求去重状态与上下文压缩协同更新:仍在上下文中展开的结果可以继续去重;已退出上下文的资料,应重新具备按需获取的条件。滑动去重的范围取决于当前可见内容,并随对话状态变化。
证据恢复可以沿两条路径进行。若压缩摘要保留了来源线索或完整工具结果的保存位置,模型可以据此回读;需要重新调用检索工具时,更新后的去重状态应允许相关资料再次返回。
这里需要分别维护当前上下文的可见性与整个研究任务的资料身份。重新读取旧论文恢复了核验条件,但没有增加独立文献的数量。若将这类回读计为新发现,压缩后的检索增量就会被高估。
帕累托前沿:检索成本与资料数量的权衡
检索投入包括时间、工具调用和模型处理资源。为了分析这些投入与资料积累之间的关系,可以建立一个简化的双目标模型:以 C 表示采用一致口径计算的检索成本,以 N 表示按统一筛选标准获得的相关、不重复资料数,分别对应成本最小化与资料数量最大化。
对于给定比较集合中的方案 A 与 B,若 C(B) ≤ C(A),N(B) ≥ N(A),且至少一个不等式严格成立,则称 B 支配 A。例如,两种方案同样获得 50 条资料,而 A 的投入为 7 个单位、B 为 4 个单位,B 就在不减少资料数量的前提下降低了成本。
在该比较集合中,不被其他方案支配的方案称为非支配方案,其对应的目标取值构成帕累托前沿(Pareto frontier)。这一概念用于描述多个目标之间无法同时改善的取舍,定义可参见 Boyd 与 Vandenberghe 的讲义。
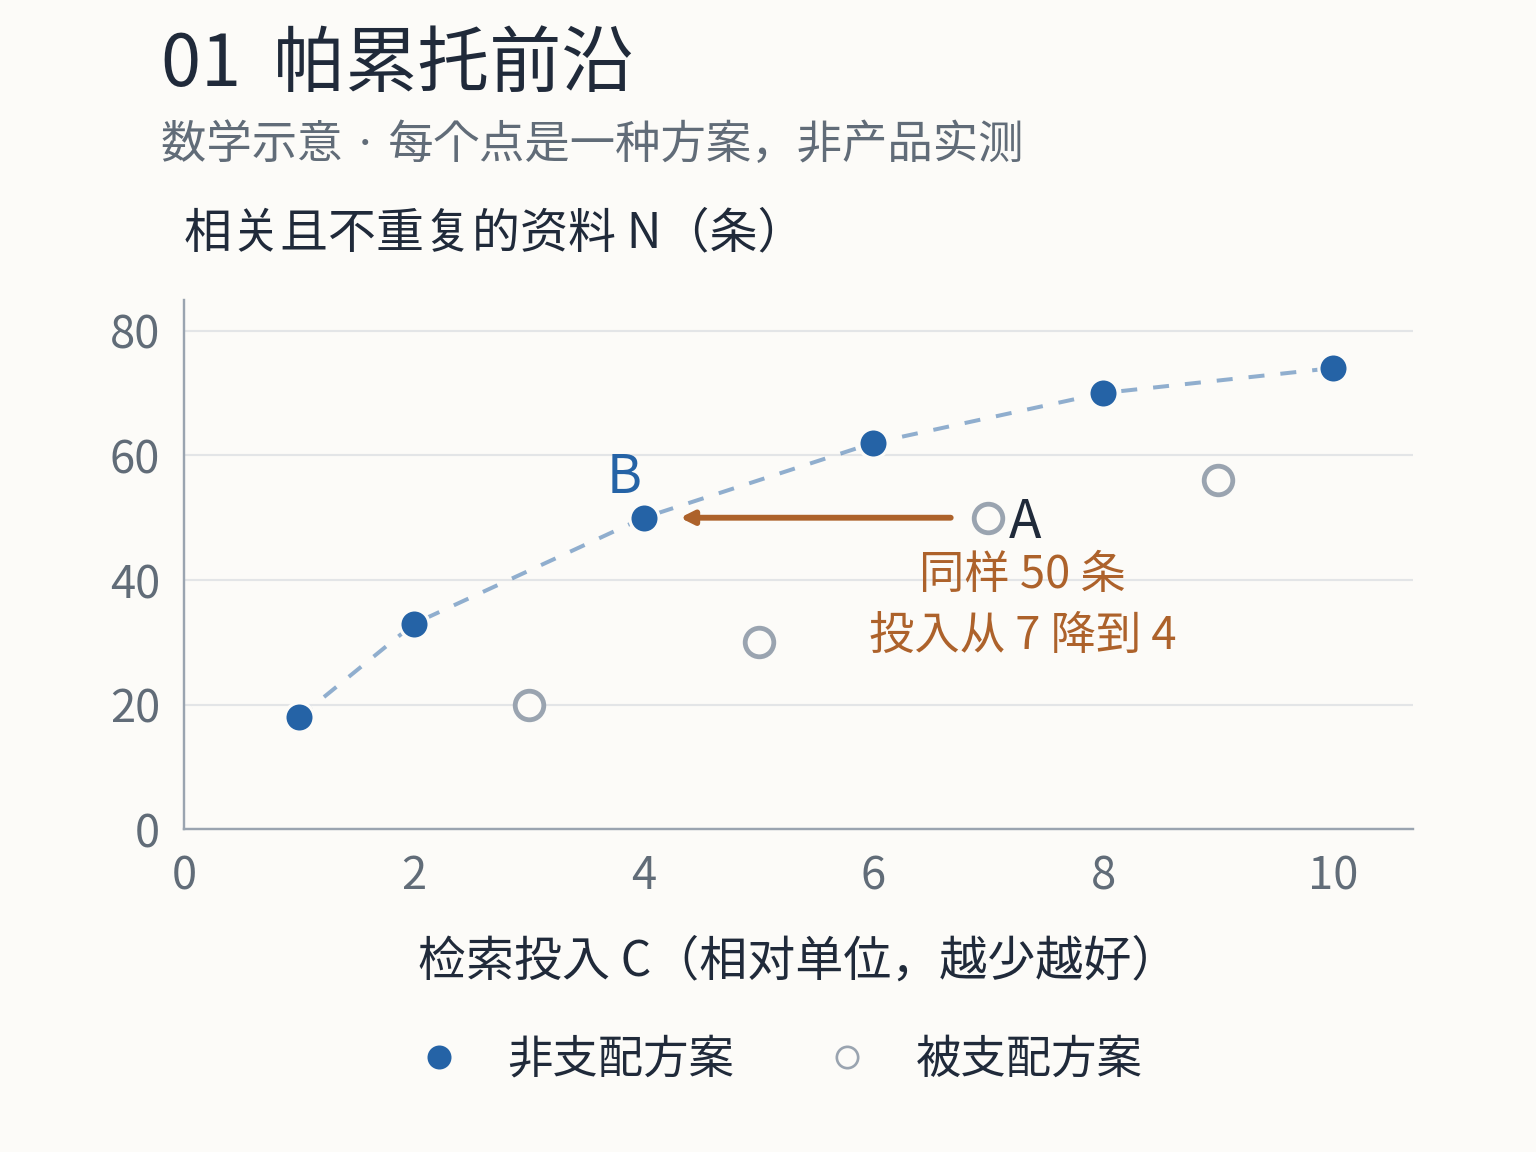
图 1:蓝色实心点构成图中比较集合的帕累托前沿,灰色空心点存在更好的替代方案。虚线仅辅助阅读,不表示中间的方案一定可实现。数字为数学示意,非 LightRead 实测。
帕累托前沿通常包含多个方案。较低成本可能对应较少的资料,更充分的资料积累则可能要求更高投入。专题讨论与系统综述对检索广度、证据完整性和时间约束的要求不同,因此仍需依据研究目标选择方案;前沿本身并不确定唯一的停止位置。
结果去重旨在减少重复展开与处理的开销,使有限投入能够用于更多相关材料;压缩后的证据恢复则保留了复核依据。两者共同影响检索方案的成本与效用。需要注意,模型中的 N 仅表示资料计数,不能替代对主题覆盖、来源可靠性和关键反例的评价,也不能直接解释为召回率。
以边际收益评估检索收敛
帕累托前沿用于比较不同检索方案。在任务执行过程中,Agent 还需要评估当前路径的增量收益,为下一步检索决策提供依据。
对已经完成的一轮检索,可以定义单位新增投入的资料收益 r = 新增资料数 ΔN ÷ 新增投入 ΔC,其中 ΔC > 0。ΔN 按整个任务已积累的资料去重,压缩后重新读取的旧论文不计为新增;ΔC 则采用一致的成本口径。该比值以有限差分描述已观察到的边际收益,不直接预测下一轮的检索结果。
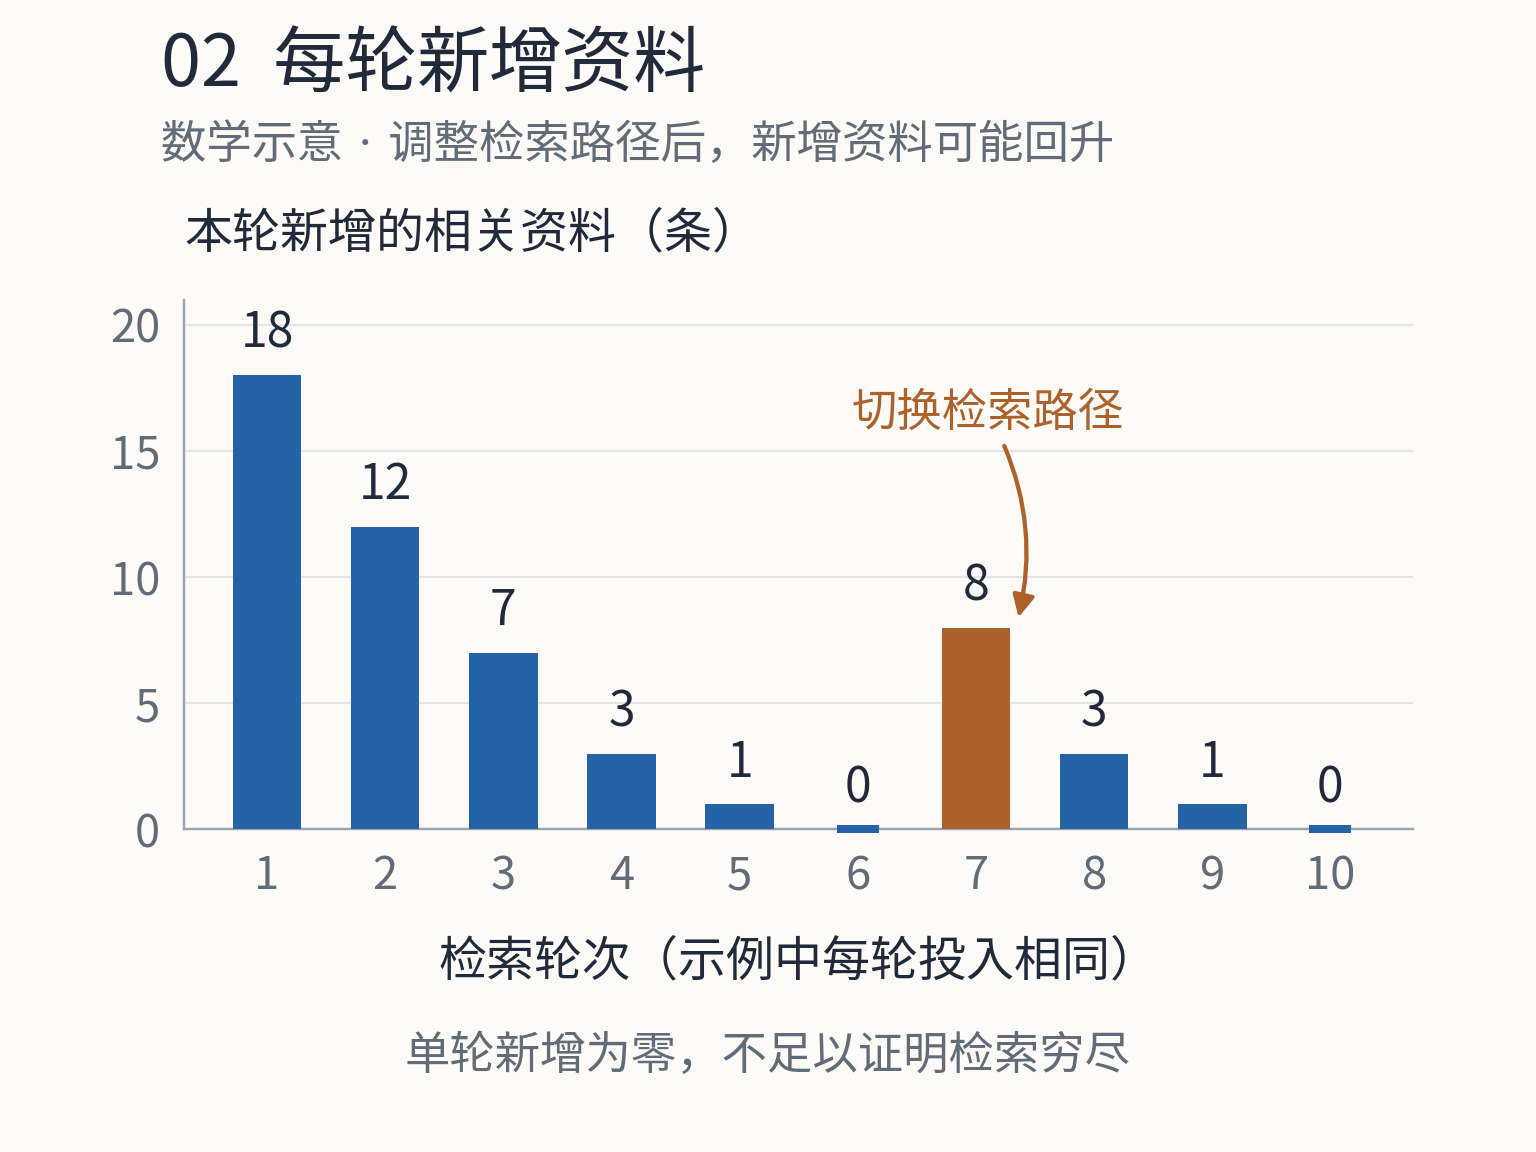
图 2:为便于比较,假设每轮投入相同,柱高直接表示本轮新增资料数。这是独立的数学示例,非产品实测,也不是图 1 中各方案的执行记录。
在投入近似相同的条件下,若后续查询主要重复命中已有资料,则说明当前路径的新增收益正在降低。不过,调整专业术语、补充数据库,或沿引用关系进入另一条研究路径,都可能带来新的增量。图 2 的第七轮展示了这种变化。
因此,边际收益下降后,仍需评估尚未覆盖的相关方向。当多条已覆盖路径持续缺少有效增量,且必要的证据核验已经完成时,才更有依据结束当前阶段的检索,转向分析与综合。能够改变研究结论的关键反例,仍可能具有较高的继续检索价值。
帕累托前沿与边际收益分别提供方案比较和执行决策的视角。单轮新增为零,既不足以证明当前方案位于全局帕累托前沿,也不足以证明相关文献已经穷尽。
检索收敛必须附带明确的范围:已经覆盖的数据库、查询条件、引文路径以及仍然存在的访问限制。未处理的分页、来源访问失败或术语覆盖不足,都不能作为检索穷尽的证据。可以作出的判断是,在本次实际覆盖的来源与路径中,继续检索的有效增量已持续降低。
异步与多 Agent 任务还应保留这些检索记录,以及阶段性停止的依据。研究者据此可以检查覆盖缺口、补充来源或调整研究问题,并在既有证据上继续推进。上下文恢复则为后续核验保留重新获取已有材料的路径。
LightRead 对长程文献研究的价值
对于准备开题、撰写综述或持续追踪研究方向的学者,选择 LightRead 的直接价值,是把检索、阅读、证据整理和后续分析交给同一个 Agent 持续推进。研究者确定研究问题、纳入标准和交付要求,Agent 据此处理查询与材料整理,减少人工逐项筛选、汇总来源,以及在不同工具之间重复交代研究背景的负担。
例如,比较同一问题的几条方法路线时,可以要求 Agent 交付文献清单、方法比较表和待核验问题,并为关键判断保留来源。研究者据此检查实验条件是否可比、证据能否支持结论,以及哪些分歧需要继续追查。检索投入由此形成可供论证使用的材料,能够进一步支持综述写作、研究方案设计和组会讨论。
导师要求补充一种方法,或审稿人质疑某项结论时,已有工作可以成为下一轮任务的起点。原文、提取表和阶段说明保存在项目目录中,Agent 可以围绕新问题补查文献、回读证据并更新结果。及时保存检索范围、关键决定与未完成事项,有助于减少重新寻找论文、整理已有结论和说明任务背景的重复投入。
研究者也保留对投入与成果的决定权。可以先为一轮任务设定预算,再根据阶段成果决定是否继续扩大范围;批量处理中的模型与资源安排由 Agent 结合任务要求处理。PDF、BibTeX、证据表与分析代码可以下载并继续用于其他工具,研究积累可以沿用到自己的写作、分析与协作流程中。
选择 LightRead,是为了让每一轮检索都为下一步研究留下可用的成果。 已经核对的证据能够回查,仍有疑问的部分有明确记录,后续分析有材料可以接续。对于需要持续补查和多次修订的课题,这意味着研究者可以将更多精力用于比较证据、形成论点与设计实验,同时保留对研究方向、资源投入和最终结论的判断权。