让 Agent 调动你的整套研究环境:LightRead 的跨设备协同
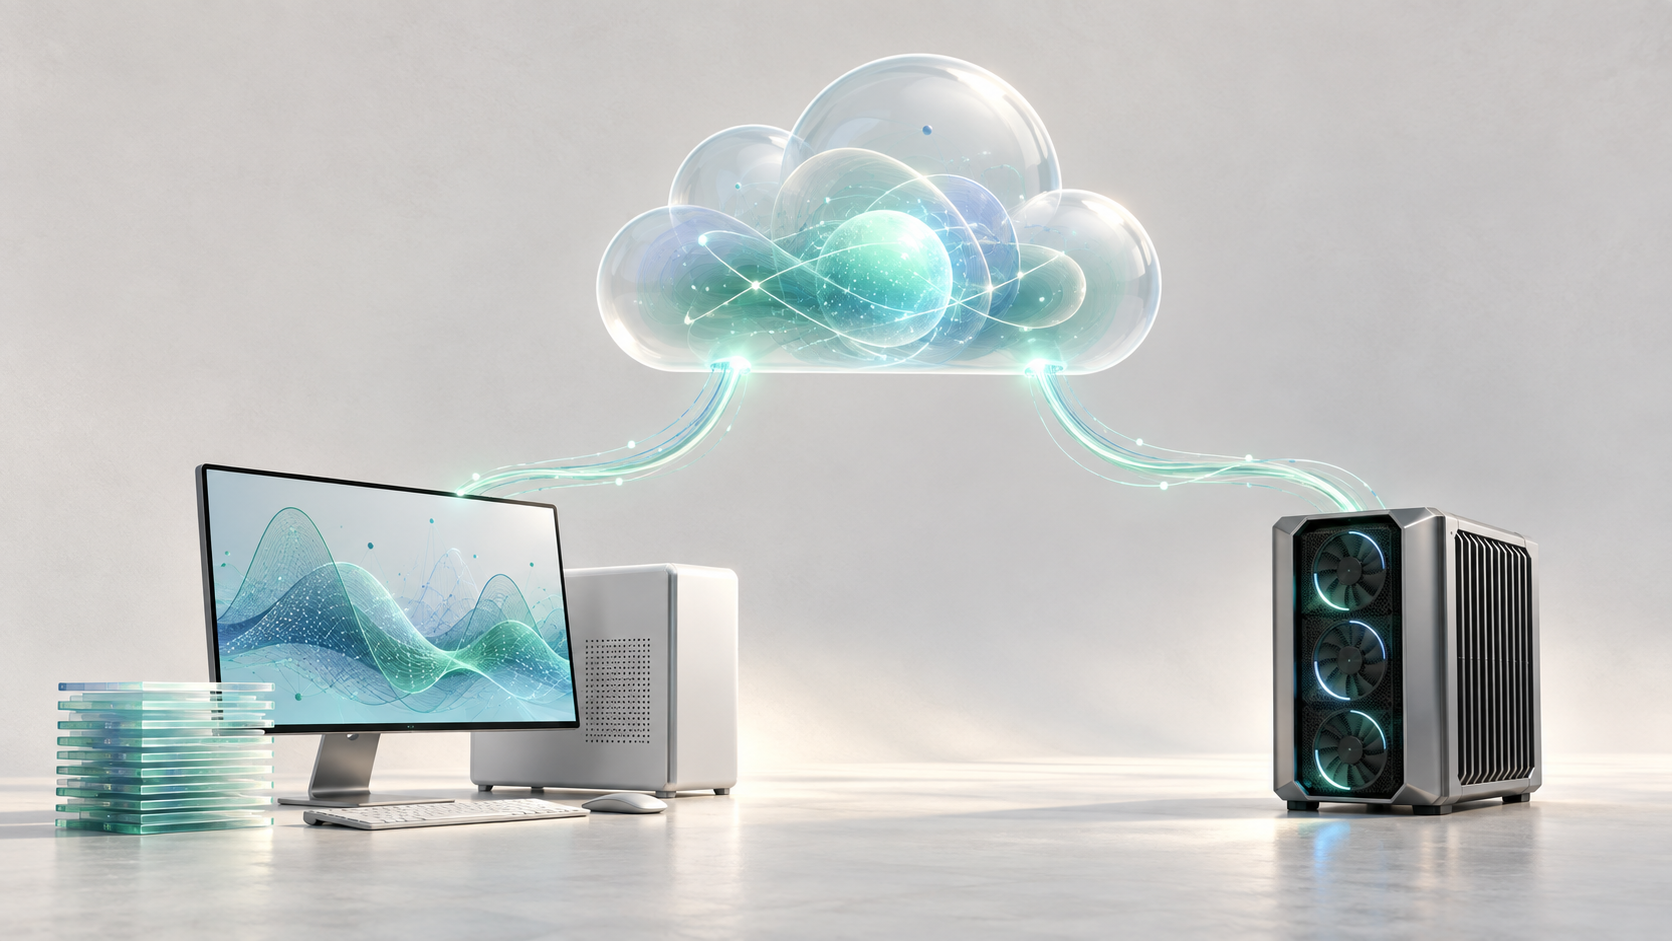
LightRead 让一个云端 Agent,联动你已经拥有的电脑、数据、软件与算力。 实验室的 Windows 工作站、自己的 Mac、运行分析代码的 Linux 服务器和 GPU 主机,可以共同参与同一场研究任务。研究者无需先把全部文件集中上传,也能让 Agent 到数据所在的设备读取材料,在适合的机器上执行计算,再把必要的结果交给下一步。
这项能力让 AI 可以进入研究者真实的工作环境。过去需要人来回切换电脑、拷贝文件、启动程序和收集结果的环节,现在有了一条由云端 Agent 组织的协作链。
研究本来就发生在多台设备上
一组实验结束后,原始测量文件还在实验室工作站的磁盘上;处理数据的 Python 环境装在 Linux 服务器里;较重的模型训练需要另一台 GPU 主机;论文、文献库和前几轮分析笔记,则留在自己的笔记本上。
这些设备各有用途。实验室工作站连接着熟悉的软件环境,服务器保留着可复用的分析代码,GPU 承担计算,个人电脑承载研究者长期积累的资料。让它们共同完成一次分析,往往需要研究者亲自安排每一次交接。
例如,在 Mac 上检查论文图表时发现需要重新拟合,就得找到 Windows 工作站里的原始表格,确认文件版本,运行分析,导出结果,再把图送回手稿目录。计算量变大时,还要把所需数据和代码交给 GPU 主机,重新收集日志与评估结果。
LightRead 把这些设备之间的交接,纳入了 Agent 能够执行的研究流程。 文件位于哪台机器、计算应该在哪里运行、下一步需要哪份产物,都可以在同一场对话中说明和推进。
通过通信,连起分散的数据与执行环境
LightRead 的 Agent 在云端组织任务。个人电脑和实验室主机通过连接器接入,GPU 主机也可以参与执行。连接建立后,Agent 能够识别可用设备,访问目标机器上的文件,在指定机器上运行终端命令,并按需发起跨设备文件传输。
连接器由设备主动向云端建立通信通道。对于能够访问 LightRead 服务的实验室主机,这种接入方式省去了为云端访问另行配置公网入站端口的步骤。Mac、Windows 和 Linux 上的文件与执行环境,由此都能进入同一个任务的调用范围。
研究者可以直接描述任务:「检查实验室电脑里这批测量数据,沿用服务器上的清洗脚本;需要显卡的部分交给 GPU 主机,最后整理对比图和报告。」Agent 据此检查设备、材料和运行条件,再执行相应步骤。
这里的“异构”,对应的就是研究中常见的差异:不同操作系统、不同文件位置、不同软件环境和不同计算能力。LightRead 为这些差异建立了可调用的通信与传输路径,让已有资源可以共同承担任务。
| 研究资源 | LightRead 如何调用 | 可以承接的工作 |
|---|---|---|
| 个人 Mac、Windows 或 Linux 电脑 | 通过连接器访问文件、运行命令 | 读取研究笔记、整理数据、复用已有脚本 |
| 实验室工作站 | 在目标机器上读写文件与执行程序 | 就地清洗实验数据,调用已安装且具备相应操作条件的专业软件 |
| Linux 服务器或 GPU 主机 | 在对应设备上执行计算、读取日志和结果 | 批量分析、模型训练、推理与评估 |
| 云电脑工作区 | 运行云端分析,保留文件与交付物 | 汇总结果、生成图表、整理报告和后续材料 |
设备接入方式可见 自建主机说明。更完整的多端架构介绍,可阅读 LightRead 怎样同时连上电脑、浏览器和文献库。
数据就地处理,文件按需流转
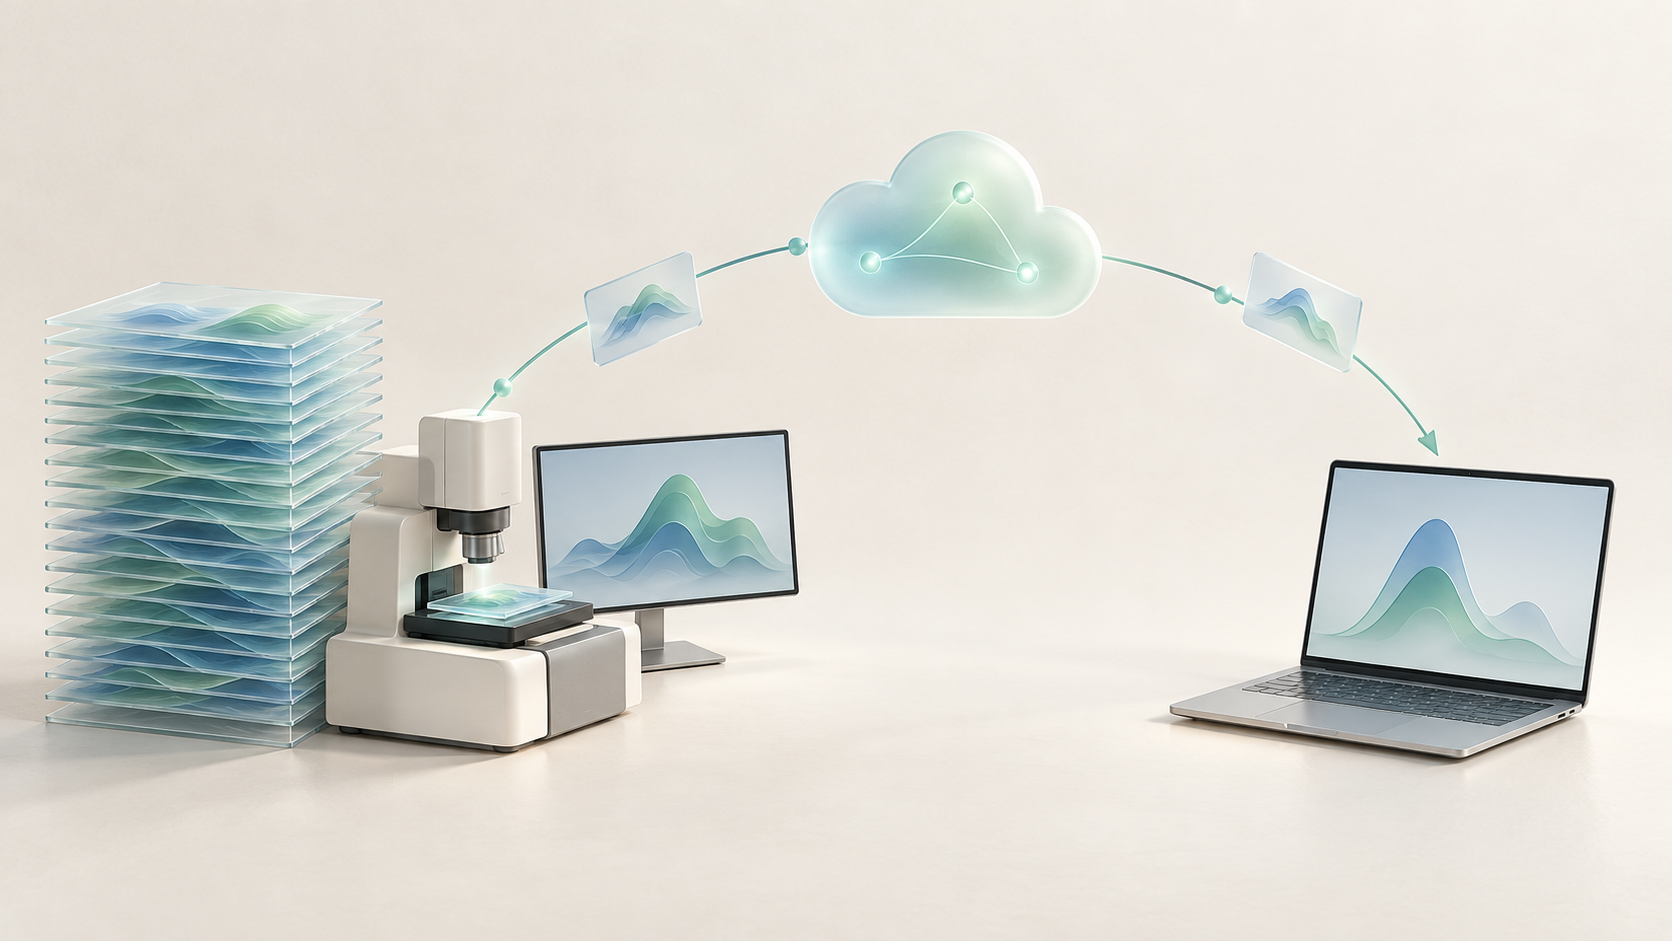
跨设备协同给研究者带来的一项直接收益,是可以灵活决定哪些文件需要移动、哪些计算适合留在原地完成。
一批测量数据已经保存在工作站上时,Agent 可以先在那台机器读取文件结构、检查样本,再直接把清洗脚本写到目标目录并执行。查看日志、搜索配置或检查结果,也可以通过远端文件工具完成。研究者无需为了让 Agent 开始工作,先打包上传整个目录。
如果下一阶段确实需要另一台设备,就把必要的输入交给它。例如,将清洗后的特征文件传给 GPU 主机,把评估汇总表交给云电脑生成报告,或者把最终图表送回手稿目录。大体积原始文件和只供当前计算使用的中间产物,可以继续留在所属设备。
这让数据存放位置、计算执行位置和研究者的操作入口,可以分别安排。 研究者从自己的笔记本或手机发起任务,计算在实验室或 GPU 主机上进行,最终报告保存到指定位置。不同设备之间的文件交接由 Agent 按任务需要发起,减少人工打包、中转和重复下载。
一次实验分析,怎样由多台设备接力完成
下面是一种基于这些能力组织的工作流:比较两批测量数据,沿用已有清洗方法,执行模型评估,最后形成图表与分析报告。
-
在数据所在的工作站检查材料。 Agent 查看两批文件的目录、字段、样本与缺失情况,确认后续分析使用哪些输入,并记录来源位置。
-
在具备环境的设备上完成清洗。 Agent 读取已有脚本,结合本次要求调整处理步骤,在目标机器执行,保存清洗结果与运行日志。原始数据可以继续保留在工作站上。
-
将需要的计算交给 GPU 主机。 当模型训练或推理需要 GPU 时,Agent 检查对应主机的运行条件,将必要的代码与输入写入或传入目标设备,再启动任务。已有 GPU 设备可以接入;需要另租算力时,LightRead 也提供 算力配置 入口。
-
依据运行结果继续分析。 计算完成后,Agent 读取日志、指标和输出文件,执行约定的结果对比。出现运行错误时,可以结合日志检查原因,修正执行问题,并依据当前任务要求安排重试。
-
把结果整理成可继续使用的材料。 必要的汇总表和图表进入指定目录,Agent 据此撰写报告,记录使用的数据、脚本、参数和产物位置,方便研究者检查,也方便下一轮沿着同一套材料继续工作。
整个流程中,代码、结果与解释可以保持关联;支撑它们的数据与执行环境,则分布在各自适合的设备上。LightRead 的跨设备能力,让这种分工可以在一场任务中完成。
云端持续推进,计算设备各司其职
较长的训练、拟合或批量处理任务,需要在运行结束后继续读结果、生成图表或整理报告。LightRead 支持在云电脑、自建主机和 GPU 主机上执行后台任务,任务结束后再唤醒 Agent,接着处理后续工作。
云端负责组织研究,接入的设备负责执行各自的计算。研究者可以关闭当前页面,稍后回来查看进展;承担计算和提供文件的设备需要保持在线。长任务的启动方式、状态检查和运行时限,也可以由 Agent 根据任务要求安排。
这种分工让研究者的交互设备更加灵活。笔记本负责提出目标和查看结果,实验室工作站保留数据与专业环境,GPU 主机承担计算,云端 Agent 连接这些环节。具体的使用方式可见 云电脑工作区。
把已有的整套研究条件交给 Agent 协同
LightRead 的跨设备创新,扩大了 Agent 能够实际参与研究的范围。研究者已经积累的数据、配置好的分析环境、购买的软件和拥有的算力,可以通过接入各自的设备进入同一条工作流程。设备之间的差异由明确的调用与传输路径连接起来,研究任务可以跨越多个文件系统和执行环境继续推进。
对实验与数据分析而言,这份价值会体现在具体的工作中:少一次手工搬运,少一次反复登录,复用一套已经验证过的环境,在计算结束后及时接上分析,并把最终产物送到下一步需要的位置。研究者负责方法选择与关键结论的确认,Agent 承接资源调用、程序执行、文件流转和结果整理,让更多精力留给研究本身。
一个云端 Agent,联动一整套研究环境。 LightRead 为研究者提供了这份协同能力:让分散的数据可以被调用,让各台设备的优势可以被组织,让已有的研究条件共同推动下一步工作。
关于云端执行与任务组织,可继续阅读 Introducing LightRead 2.0 底层架构解析;个人文献与知识库的联动实践,见 从散落的 PDF,到规整的 Zotero 和 Obsidian。